Firma nie musi dzisiaj wiedzieć, z jakiego modelu AI będzie korzystała za trzy czy pięć lat. Powinna jednak już dziś zadbać o to aby przyszły model czy modele miały na czym lub z czym pracować.
To właśnie dlatego warto rozróżnić dwie rzeczy, które w codziennym języku często wrzucamy do jednego worka: digitalizację dokumentów i digitalizację danych. Zeskanowanie papierowego protokołu i zapisanie go jako PDF digitalizuje nośnik. Zapisanie każdego wyniku jako uporządkowanego rekordu powiązanego z produktem, partią, procesem, maszyną, operatorem, czasem, jednostką, tolerancją i statusem digitalizuje informację.
Z perspektywy człowieka oba podejścia mogą wyglądać podobnie: „przecież wszystko mamy w komputerze”. Z perspektywy analityki, automatyzacji i przyszłej sztucznej inteligencji są to jednak dwa zupełnie różne światy.
Digitalizacja i AI
AI potrafi przeczytać skan. Ale to nie rozwiązuje problemu kontekstu
Dzisiejsze modele multimodalne potrafią analizować PDF-y, skany, tabele i obrazy. Właściwe pytanie nie brzmi więc już: „czy AI potrafi przeczytać protokół?”.
Znacznie ważniejsze pytanie brzmi: ile pracy trzeba wykonać, aby z dokumentu odzyskać dane z takim kontekstem, dokładnością i spójnością, żeby można było oprzeć na nich analizę?
Załóżmy, że na protokole kontroli znajduje się liczba „4,7”. Człowiek widzący cały formularz może od razu rozumieć, że jest to np. pH produktu z konkretnej partii, pobranej o określonej godzinie na konkretnej linii. Sama wartość 4,7 nie zawiera jednak tego znaczenia. System analizujący dokument musi rozpoznać układ strony, nagłówki, relację wartości z etykietą, produkt, partię, datę, jednostkę, wersję formularza oraz inne pola potrzebne do interpretacji.
Jeżeli te relacje powstają już podczas wykonywania kontroli w systemie QMS, późniejsza analiza nie musi ich każdorazowo odtwarzać. To różnica pomiędzy odczytywaniem dokumentu a korzystaniem z danych.
ISO/IEC 25012:2008 definiuje model jakości danych dla danych utrzymywanych w ustrukturyzowanej formie w systemie komputerowym; norma została ponownie potwierdzona jako aktualna w 2025 r. Źródło: ISO
Co zmienia icmInspector QMS?
icmInspector QMS digitalizuje proces kontroli jakości – od planowania kontroli i rejestracji danych po raportowanie, analizę oraz automatyczne reakcje na wyniki. Z punktu widzenia przyszłego AI najważniejsze jest jednak to, że kolejne kontrole mogą tworzyć uporządkowaną historię rzeczywistego procesu, a nie tylko kolejne pliki w archiwum.
Dane jakościowe mogą być wiązane m.in. z produktem, partią, zleceniem, linią, maszyną, operatorem, krokiem kontroli, datą i czasem wykonania, zmierzoną wartością, jednostką, zakresem tolerancji, statusem OK/NOK, zdjęciem, niezgodnością i działaniem następczym – zależnie od konfiguracji procesu i zakresu rejestrowanych informacji.
Jeżeli w procesie zapisywane są również znaczniki czasu rozpoczęcia i zakończenia kolejnych czynności, z czasem powstaje dodatkowo cyfrowy ślad pokazujący, jak proces faktycznie przebiegał. To może mieć znaczenie nie tylko dla jakości, lecz również dla process miningu, optymalizacji i przyszłej automatyzacji.
Opis funkcjonalny icmInspector wskazuje m.in. na cyfryzację procesu od planowania i zbierania danych w czasie rzeczywistym po raportowanie, analizy statystyczne oraz automatyczne scenariusze alarmowe.
Plik cyfrowy nie zawsze oznacza dane gotowe dla AI
Źródło
Co jest dobre
Co trzeba odtworzyć
Gotowość do analizy AI
Baza / QMS
Struktura, relacje, typy danych, walidacja
Głównie dobór właściwego wycinka danych
Wysoka
Standaryzowany Excel
Może mieć spójny schemat i wartości tabelaryczne
Wersje, słowniki, relacje między plikami, walidacja
Średnia do wysokiej
Word / PDF tekstowy
Treść można zwykle wydobyć bez klasycznego OCR
Układ, znaczenie pól, relacje, wersje formularzy
Średnia
Skan / PDF obrazowy
Zachowuje obraz dokumentu
OCR, layout, pola, tabele, kontekst, walidacja
Niska do średniej
Ile kosztuje odzyskanie struktury z dokumentów? Symulacja
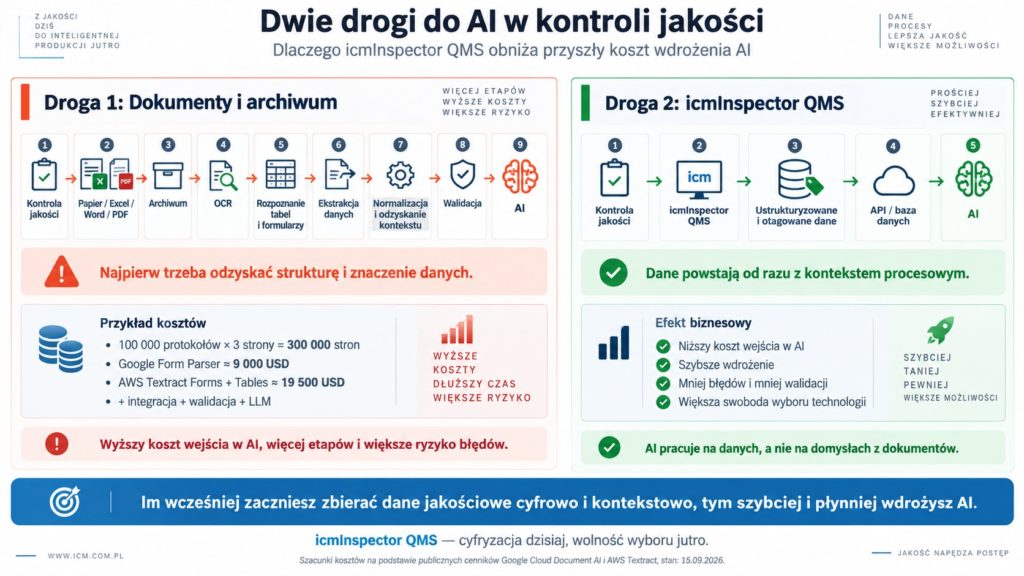
Przyjmijmy dwa warianty archiwum: 10 000 protokołów oraz 100 000 protokołów. Zakładamy średnio 3 strony na protokół, czyli odpowiednio 30 000 i 300 000 stron. To scenariusz referencyjny – rzeczywiste koszty zależą od typu dokumentów, jakości skanów, liczby wersji formularzy, wymaganej dokładności i wybranej architektury.
Usługa
Stawka referencyjna
30 000 stron
300 000 stron
Google Document AI – Enterprise OCR
$1,50 / 1000 stron po pierwszym 1000 bez opłat
$43,50
$448,50
Google Document AI – Layout Parser
$10 / 1000 stron
$300
$3 000
Google Document AI – Form Parser
$30 / 1000 stron
$900
$9 000
AWS Textract – OCR
$0,0015 / stronę (pierwszy 1 mln, US West Oregon)
$45
$450
AWS Textract – Forms + Tables
$0,065 / stronę (0,05 + 0,015)
$1 950
$19 500
Źródła cen: Google Cloud Document AI Pricing i Amazon Textract Pricing. Kwoty w USD, bez podatków i kosztów innych komponentów chmurowych. Stan: 15.09.2026.
Sama tabela pokazuje ważną różnicę: rozpoznanie tekstu jest stosunkowo tanie, ale rekonstrukcja struktury formularzy i tabel może kosztować wielokrotnie więcej. Co więcej, rachunek z usługi OCR lub parsera nadal nie obejmuje wszystkich prac potrzebnych do stworzenia wiarygodnego zbioru danych.
W praktyce mogą dojść: klasyfikacja dokumentów, mapowanie pól pomiędzy różnymi wersjami formularzy, normalizacja jednostek, identyfikacja produktów i partii, deduplikacja, kontrola braków, reguły walidacyjne, obsługa wyjątków oraz ręczna weryfikacja przypadków o niskiej pewności.
Tokeny: dlaczego nie warto sprowadzać całego problemu do ceny modelu
Koszt tokenów jest ważny, ale bywa najbardziej widoczną – i jednocześnie niekoniecznie największą – pozycją. Dostawcy przetwarzają dokumenty w różny sposób, dlatego koszt „jednej strony PDF” nie jest uniwersalny.
Google podaje obecnie, że strona PDF w Gemini odpowiada 258 tokenom obrazu. Dla 30 000 stron to ok. 7,74 mln tokenów, a dla 300 000 stron ok. 77,4 mln. Przy promocyjnej cenie Gemini 3.8 Flash wynoszącej $0,75 za milion tokenów wejściowych do końca 2026 r. daje to odpowiednio ok. $5,81 i $58,05 samego wejścia stron jako obrazów. Google dodatkowo wskazuje, że w modelach Gemini 3 tekst natywnie osadzony w PDF jest wyodrębniany i nie jest naliczany jako tokeny tekstowe PDF.
Claude działa inaczej. Anthropic podaje, że przy PDF każda strona jest konwertowana do obrazu, a tekst strony jest ekstrahowany i przekazywany obok obrazu. Typowa strona zużywa według dokumentacji ok. 1 500–3 000 tokenów tekstowych, do czego dochodzi koszt tokenów obrazu. Dla 300 000 stron daje to 450–900 mln tokenów samej części tekstowej. Przy cenie Claude Sonnet 5 wynoszącej $2 za milion tokenów wejściowych oznacza to ok. $900–1 800 przed doliczeniem obrazu, odpowiedzi i dalszego przetwarzania.
Te liczby nie dowodzą, że jeden dostawca jest „lepszy” od drugiego. Pokazują coś bardziej istotnego: koszt dokumentów silnie zależy od sposobu ich reprezentacji przez konkretną platformę. Dlatego trwałą przewagą nie jest optymalizacja pod jeden model, lecz posiadanie danych w postaci, którą można udostępnić różnym modelom w sposób kontrolowany.
Dokumentacja Anthropic: typowo 1 500–3 000 tokenów tekstu na stronę PDF + tokeny obrazu. Claude PDF support
A co, jeśli dane są już w systemie?
W systemie QMS lub w warstwie analitycznej nie trzeba przekazywać modelowi całej historii firmy. SQL, API lub inna warstwa danych może najpierw przefiltrować rekordy i przygotować tylko ten kontekst, który jest potrzebny do konkretnej analizy.
Dla porównania przyjmijmy bardzo duży pakiet analityczny: 100 000 tokenów wejściowych i 5 000 tokenów odpowiedzi. Poniższa tabela pokazuje koszt samego LLM przy standardowych/publicznych stawkach API na 15.09.2026. Modele różnią się możliwościami,
Model / API
Input / 1 mln
Output / 1 mln
100k input + 5k output
OpenAI GPT-5.6 Luna
$0,20
$1,20
$0,026
Google Gemini 3.8 Flash
$0,75
$3,75
$0,094
Anthropic Claude Sonnet 5
$2
$10
$0,25
OpenAI GPT-5.6 Terra
$2
$12
$0,26
OpenAI GPT-5.6 Sol
$4
$20
$0,50
Anthropic Claude Opus 4.8
$5
$25
$0,625
OpenAI GPT-6 Astra
$10
$50
$1,25
Gemini 3.8 Flash: cena promocyjna do 31.12.2026. GPT-5.6 Sol: cena promocyjna co najmniej do 21.11.2026. Ceny mogą się zmieniać; przed publikacją po dłuższym czasie warto je ponownie sprawdzić.
Koszty, których nie ma w cenniku tokenów
Jeżeli firma posiada głównie dokumenty, projekt AI może zacząć się nie od modelu, lecz od projektu data engineering. Typowy łańcuch może wyglądać tak:
Przy danych ustrukturyzowanych ścieżka może być krótsza:
icmInspector QMS → uporządkowane rekordy → filtrowanie / agregacja → wybrany kontekst → model AI
Do rachunku trzeba doliczyć również pracę człowieka. Przykładowo: jeśli tylko 5% z 100 000 protokołów wymaga ręcznej weryfikacji, a kontrola jednego przypadku zajmuje średnio 2 minuty, daje to ponad 166 godzin pracy. Przy hipotetycznym koszcie pracy 100 zł/h jest to ok. 16 700 zł. Przy 10% przypadków – ponad 333 godziny i ok. 33 300 zł. To nie są dane rynkowe, lecz prosta analiza wrażliwości pokazująca, jak szybko koszt walidacji może przewyższyć sam koszt tokenów.
Błąd OCR nie jest tylko błędem tekstu – może stać się błędem analizy
OCR jest dziś bardzo dobry, ale nie jest bezbłędny. Badanie porównujące Tesseract, Amazon Textract i Google Document AI objęło 18 568 dokumentów i ponad 51 tys. operacji przetwarzania. Wyniki różniły się pomiędzy systemami, a zaszumienie materiału pogarszało dokładność. Autor pokazał również, że zadania NLP wymagające detali – w szczególności rozpoznawanie nazwanych encji – były szczególnie wrażliwe na błędy OCR.
Inne badanie dotyczące wyszukiwania informacji w materiałach po OCR wykazało statystycznie istotne pogorszenie wyników w wielu konfiguracjach już od 5% word error rate. Nie jest to uniwersalny próg dla kontroli jakości, lecz dobra ilustracja propagacji błędu: błąd na etapie pozyskania danych może wpływać na kolejne etapy analizy.
W kontroli jakości ma to dodatkowe znaczenie. Pomyłka w zwykłym słowie może być niegroźna. Pomylenie 0,47 z 0,41, 5,8 z 58, identyfikatora partii A103 z A108 albo statusu OK z NOK może całkowicie zmienić wynik analizy.
Dlaczego jest to szczególnie ważne w produkcji spożywczej i seryjnej?
W produkcji spożywczej znaczenie ma nie tylko wynik pojedynczego pomiaru, ale jego pełny kontekst: produkt, partia, dostawca, linia, zmiana, czas, warunki procesu, CCP/CP, niezgodność i działanie korygujące. Firma może chcieć w przyszłości zapytać: „czy istnieje kombinacja dostawcy, linii, zmiany i warunków procesu, która poprzedza wzrost liczby przekroczeń parametru X?”.
W produkcji seryjnej analogiczne pytanie może dotyczyć korelacji wyniku pomiaru z maszyną, gniazdem, operatorem, materiałem, numerem narzędzia, dostawcą albo godziną produkcji.
Jeżeli dane są ustrukturyzowane, baza może najpierw wykonać filtrowanie, agregację i selekcję. Model AI dostaje
Czas realizacji kontroli też może stać się wartościową daną
Jeżeli system zapisuje kolejność czynności oraz znaczniki czasu poszczególnych kroków, dane jakościowe mogą zacząć pełnić również rolę event logu procesu. W process miningu minimalny event log zawiera Case ID, Activity i Timestamp; dodatkowe atrybuty, takie jak pracownik czy urządzenie, zwiększają możliwości analizy.
Badania nad process miningiem w produkcji pokazują wykorzystanie takich logów do odkrywania przebiegu procesów, analizowania odchyleń, korelacji i możliwości poprawy efektywności. Oznacza to, że dane gromadzone dzisiaj w celu kontroli jakości mogą w przyszłości wspierać również analizę przepływu pracy, wąskich gardeł, czasów realizacji czy predykcję odchyleń.
Ten kierunek jest interesujący, ale wymaga precyzji. Dane QMS nie są same w sobie kompletnym zbiorem treningowym dla robota. Nowoczesne modele robotyczne uczą się także z obrazu, stanu robota, działań, trajektorii, demonstracji i danych syntetycznych.
NVIDIA w materiałach dotyczących GR00T opisuje zbiory obejmujące m.in. obraz/wideo, stan i akcje robota. To pokazuje, dlaczego nie należy obiecywać, że sama historia QMS „nauczy robota ruchu”.
Może natomiast dostarczyć bardzo ważnej warstwy semantycznej: jaka czynność była wykonywana, w jakiej kolejności, jak długo trwała, jakiego produktu dotyczyła, jakie były warunki i czy rezultat spełniał wymagania jakościowe. W przyszłości takie dane można łączyć z danymi z kamer, maszyn, czujników i robotów. Wtedy QMS pomaga opisać nie tylko „co robot zrobił”, lecz również „czy z punktu widzenia jakości proces został wykonany prawidłowo”.
Najważniejsza inwestycja pod AI? Nie konkretny model. Dane.
Za trzy lata najlepszy dla danej firmy model może pochodzić od OpenAI, Google, Anthropic, europejskiego dostawcy, działać lokalnie albo być elementem rozwiązania, którego dziś jeszcze nie ma. Ceny tokenów, limity i architektury również będą inne.
Dlatego najważniejszą decyzją nie jest dziś wybór jednego modelu AI. Ważniejsze jest pytanie: czy za kilka lat będziemy posiadać dane, które możemy temu modelowi jednoznacznie, bezpiecznie i efektywnie udostępnić?
Firma posiadająca uporządkowane dane może zmieniać dostawcę modeli, budować RAG, integrować AI z hurtownią danych, stosować modele chmurowe lub lokalne oraz rozwijać analitykę predykcyjną. Firma posiadająca przede wszystkim archiwum dokumentów często musi najpierw zbudować warstwę danych, która z tych dokumentów odzyska strukturę i znaczenie.
icmInspector QMS: cyfryzacja dzisiaj, wolność wyboru jutro
Wdrożenie icmInspector QMS nie powinno być postrzegane wyłącznie jako zastąpienie papierowego formularza tabletem. Każda kolejna kontrola wykonywana cyfrowo może budować uporządkowaną historię procesu. Po miesiącu są to tysiące rekordów. Po kilku latach – setki tysięcy lub miliony obserwacji, które mają znaczenie nie tylko dla raportowania, ale potencjalnie także dla przyszłej analityki i automatyzacji.
Im wcześniej firma zacznie gromadzić ustrukturyzowane, kontekstowe dane jakościowe, tym mniej informacji będzie musiała później odzyskiwać, rekonstruować i ręcznie weryfikować. To może oznaczać niższy koszt wejścia w AI, krótszy czas wdrożenia, mniejsze ryzyko błędów i większą swobodę wyboru technologii.
Dlatego icmInspector QMS to nie tylko pierwszy krok do cyfryzacji kontroli jakości. To również inwestycja w przyszłą możliwość wyboru – modelu AI, sposobu integracji, architektury chmurowej lub lokalnej i kierunku automatyzacji.
Tagi: predictive qualitydane strukturalne a PDFprocess mining w produkcji
Mogą zainteresować Cię również
Baza wiedzy
Kompletne dane to nie to samo co dobre dane — ALCOA+ w kontroli jakości
Stuprocentowo wypełniony arkusz Excela nie znaczy, że dane są wiarygodne. Poznaj standard ALCOA+ i sprawdź, dlaczego icmInspector QMS rejestruje dokładnie to, czego arkuszowi brakuje.
Baza wiedzy
Ile oszczędza firma wdrażając icmInspector QMS? Pełna kalkulacja ROI
Ile realnie oszczędza firma po wdrożeniu icmInspector QMS? Przeliczamy czas pracy na pieniądze według danych GUS, dokładamy koszt wdrożenia i abonamentu, a dla zespołu 10 osób wyliczamy zwrot inwestycji — ok. 3 miesiące i ROI ~94% już w pierwszym roku.
Baza wiedzy
Czy Twój system zarządzania jakością jest gotowy na wymagania NIS2?
Sprawdź, czy Twój system zarządzania jakością wspiera wymagania NIS2. Wypełnij ankietę i zobacz, które obszary wymagają zmian, aby zwiększyć zgodność i kontrolę procesu.
Baza wiedzy
Kontrola jakości a NIS2: dlaczego papierowa dokumentacja przestaje wystarczać
Dowiedz się, jak prowadzić kontrolę jakości zgodnie z NIS2. Sprawdź, dlaczego papierowa dokumentacja utrudnia zgodność, audyt i reakcję na incydenty oraz jak cyfrowy QMS wspiera wymagania NIS2.
Jeżeli Twoja firma dostarcza rozwiązania dla podmiotów zajmujących się produkcją spożywczą lub przemysłową z przyjemnością nawiążemy współpracę partnerską! Więcej o modelu współpracy znajdziesz w sekcji Dla partnerów.